
- H200 построена на той же архитектуре Hopper, что и H100. Вычисления у них близки, разница в памяти: 141 ГБ HBM3e против 80 ГБ и 4,8 ТБ/с против 3,35 ТБ/с.
- Карта нужна, когда в 80 ГБ не помещаются веса модели, длинный контекст или нужное число одновременных запросов.
- Llama 3.1 70B в FP8 вместе с контекстом 128 тысяч токенов помещается в одну H200. На H100 для этого не хватает памяти.
- Полное дообучение 70B не помещается даже в сервер на 8 × H200; вместо него берут LoRA или QLoRA, а для полного дообучения — несколько серверов.
Содержание8 разделов
H200 берут ради памяти. Тензорные ядра, набор форматов и NVLink у неё те же, что у H100 SXM, а памяти почти в 1,8 раза больше, и читается она быстрее. Для языковых моделей это главный ресурс: веса, KV-кэш контекста и состояние оптимизатора при обучении живут в видеопамяти, и когда она кончается, задачу приходится делить между картами.
Поэтому вопрос «нужна ли мне H200» сводится к арифметике: сколько гигабайт займёт ваша модель с вашим контекстом. Мы посчитали это для моделей на 13B, 34B и 70B, а конфигурации, цены «от» и условия запуска собраны на странице аренда H200.
Что изменилось по сравнению с H100
H200 вышла как обновление H100 внутри поколения Hopper. NVIDIA поменяла память: HBM3 на HBM3e, 80 ГБ на 141 ГБ. Связь между картами (NVLink 900 ГБ/с на GPU) и предельная мощность SXM-версии (до 700 Вт) остались прежними. Для LLM это значит, что одна и та же модель на H200 считает с той же скоростью, но получает больше места и быструю подачу данных.
| H100 SXM | H200 SXM | Что это даёт LLM | |
|---|---|---|---|
| Память на GPU | 80 ГБ HBM3 | 141 ГБ HBM3e | Больше модель или длиннее контекст на одной карте |
| Скорость памяти | 3,35 ТБ/с | 4,8 ТБ/с | Быстрее генерация токенов: на этапе ответа модель упирается в чтение весов и кэша |
| NVLink на GPU | 900 ГБ/с | 900 ГБ/с | Без изменений: обмен между картами при обучении тот же |
| Мощность | до 700 Вт | до 700 Вт | Сервер под H100 SXM обычно подходит по питанию и охлаждению |
| MIG | до 7 × 10 ГБ (SXM) | до 7 × 18 ГБ (SXM) | В каждый экземпляр H200 помещается модель на 7B в FP16 (≈ 14 ГБ весов) |
Пришлём 2–3 варианта с форм-фактором, числом GPU и ценой. Ответим за 15 минут в рабочее время.
Оставить заявкуПочему скорость памяти важна именно для ответа модели. Когда LLM генерирует текст, на каждый новый токен она заново читает все веса и накопленный кэш. Вычислений на этом шаге мало, а данных много, поэтому время ответа ограничивает пропускная способность памяти, и на генерации прибавка H200 заметнее, чем на обучении.
Какие модели помещаются в 141 ГБ
Веса модели занимают «число параметров × байт на параметр». В FP16 и BF16 параметр занимает 2 байта, в FP8 и INT8 — 1 байт, при 4-битном квантовании — половину байта. Для трёх типичных размеров получается так.
| Модель | FP16 / BF16 | FP8 / INT8 | 4 бита |
|---|---|---|---|
| 13B | 26 | 13 | 6,5 |
| 34B | 68 | 34 | 17 |
| 70B | 140 | 70 | 35 |
Что из этого следует для одной карты:
- 13B помещается в любую из двух карт в любой точности. H200 тут выигрывает только запасом под контекст и число запросов.
- 34B в FP16 на H100 оставляет около 12 ГБ на всё остальное, на H200 — около 73 ГБ. Разница между «работает с коротким контекстом» и «спокойно держит длинные диалоги».
- 70B в FP8 на H100 оставляет около 10 ГБ, на H200 — около 71 ГБ.
- 70B в FP16 весит 140 ГБ. Формально это меньше 141 ГБ, но места под кэш и служебные буферы не остаётся, поэтому для неё берут две H200.
Длинный контекст и KV-кэш: где 141 ГБ видны сильнее всего
Во время генерации модель хранит для каждого токена контекста ключи и значения внимания — это KV-кэш. Он растёт линейно с длиной контекста и с числом одновременных запросов. Для Llama 3.1 70B (80 слоёв, 8 KV-голов) кэш в FP16 занимает около 0,33 МБ на токен; формула и расчёт по шагам — в статье сколько видеопамяти нужно для LLM.
- свободно на H200 после весов 70B в FP8 — 71 ГБ
- свободно на H100 — 10 ГБ
Отсюда два практических вывода.
Первый — про длину контекста. Весь кэш одного запроса на 128 тысяч токенов занимает около 43 ГБ. Вместе с весами в FP8 это примерно 113 ГБ: в H200 помещается, в H100 нет. Если продукту нужны длинные документы, договоры, переписка или код целиком, H200 закрывает это одной картой.
Второй — про параллельные запросы. При контексте 8 тысяч токенов на один запрос уходит около 2,7 ГБ. Свободные после весов 71 ГБ вмещают порядка двух десятков таких запросов одновременно, если оставить запас на буферы. На H100 в тех же условиях их будет единицы. Для сервиса с живыми пользователями это прямо переводится в число карт, которые нужно держать.
Обучение и дообучение: одна H200 или восемь
При полном обучении в смешанной точности с Adam на каждый параметр уходит 6 + 8 + 4 = 18 байт (наш подсчёт по Hugging Face: две копии весов, состояние оптимизатора, градиенты) плюс активации. Поэтому полное дообучение 7B ещё помещается в одну H200, модели на 34B нужен сервер на восемь карт, а 70B не помещается и в него. LoRA и QLoRA замораживают базовые веса: QLoRA на 70B идёт на одной H200, LoRA с весами в BF16 — на двух. Расчёт по моделям и устройство сервера на восемь GPU — в статье 8 × H200 на платформе HGX.
- Инференс 13B–70B в FP8, контекст до 128K
- QLoRA на 70B
- Полное дообучение 7B
- 70B в FP16
- LoRA на 70B
- Полное дообучение 34B
- Полное дообучение 70B (несколько серверов)
- Обучение с нуля
- Модели на сотни миллиардов параметров
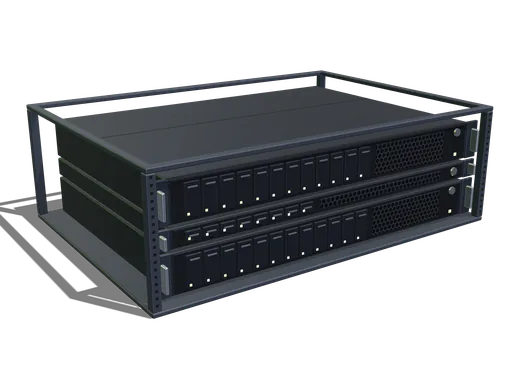
Сервер на восемь H200 с NVLink нужен для полного дообучения моделей от 34B, обучения с нуля и инференса моделей, не влезающих в пару карт.
SXM или NVL: какую H200 вы получите
H200 выпускается в двух вариантах. SXM ставится на плату HGX и связана с соседями NVLink через коммутаторы, мощность до 700 Вт. NVL — карта PCIe с мостами NVLink на две или четыре карты, мощность до 600 Вт. Память у обеих одинаковая: 141 ГБ и 4,8 ТБ/с.
Для инференса на одной-двух картах разница почти не видна. Для обучения на восьми картах нужен SXM: только там все восемь связаны в одну быструю сеть. Подробнее про буквы в названиях — в статье SXM, PCIe, NVL, HGX и DGX. Какой вариант стоит у конкретной конфигурации на 1–4 GPU, мы называем в ответе на заявку; сервер на 8 × H200 — это SXM на плате HGX.
Когда H200 не нужна
За память H200 стоит платить, только если вы в неё упираетесь. Признаки, что хватит карты попроще:
- Модель до 13B, контекст короткий, пользователей немного. H100 или даже A100 справятся, и час будет дешевле.
- Вы дообучаете модель через LoRA или QLoRA и уже укладываетесь в 80 ГБ с нормальным батчем.
- Задача упирается в вычисления: например, обучение небольшой модели на большом наборе данных. Здесь H200 почти не отличается от H100 SXM.
- Нужны много мелких изолированных сред для команды или учебных стендов. Их проще нарезать из нескольких карт попроще.
А если 141 ГБ на карту уже мало — модель на сотни миллиардов параметров или контекст на миллион токенов, — смотрите поколение Blackwell: у чипа B300 до 288 ГБ, в DGX B300 на карту приходится около 260 ГБ (2,1 ТБ на восемь карт). Как выбирать между H100, A100 и H200 (поколения Hopper и Ampere) под задачу, разобрано в статье H100, A100 или H200.
Как попробовать H200 на своей задаче
В Ampuna H200 доступна в сборках от 1 до 8 GPU. Цена за одну H200 — от 630,00 ₽/ч (≈ 459 900 ₽/мес), сервер на 8 GPU — от 5 040,00 ₽/ч. Оплата — аванс за первый месяц, сервер запускаем до 3 рабочих дней после оплаты.
NVIDIA H200Hopper · 141 ГБ HBM3e · Россия141 ГБ HBM3e на GPUот 630 ₽/ч≈ 459 900 ₽/месОткрыть H200 →8 × NVIDIA H200Hopper · 141 ГБ HBM3e · Россия8 × H200: SXM на плате HGXот 5 040 ₽/ч≈ 3 679 200 ₽/месОткрыть H200 →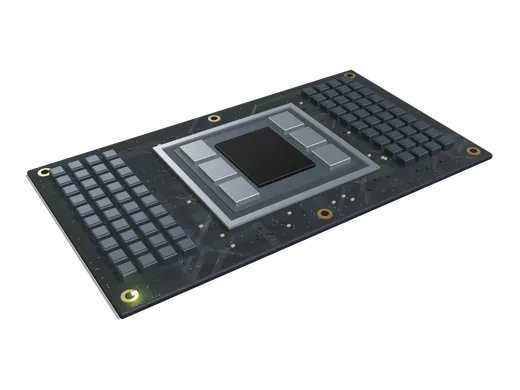
Вопросы и ответы
Хватит ли одной H200 для модели на 70B?
Для инференса — да, если веса в FP8 или в 4 битах: 70 ГБ или 35 ГБ на веса, остальное уходит под контекст и параллельные запросы. В FP16 веса занимают 140 ГБ, и для работы нужна вторая карта. Для QLoRA одной H200 тоже хватает; полное дообучение 70B требует больше восьми карт или выгрузку состояния оптимизатора в память процессора.
Чем H200 лучше H100 для инференса?
Двумя вещами: на одну карту помещается больше модели и контекста (141 ГБ против 80 ГБ), а генерация токенов идёт быстрее за счёт памяти 4,8 ТБ/с против 3,35 ТБ/с. Вычислительные блоки у карт одного поколения Hopper.
Что значит HBM3e?
Это тип памяти, установленной прямо рядом с чипом GPU. Буква «e» обозначает расширенную версию HBM3 с большей скоростью. У H200 её 141 ГБ со скоростью 4,8 ТБ/с.
Какой контекст поместится в H200?
Зависит от модели. У Llama 3.1 70B кэш в FP16 занимает около 0,33 МБ на токен, и полный контекст 128 тысяч токенов — около 43 ГБ. Вместе с весами в FP8 это помещается в одну карту.
 8 × H200